
PocketPal AI es una aplicación gratuita y de código abierto que ejecuta modelos de lenguaje directamente en el móvil, sin enviar las conversaciones a ningún servidor. Una vez descargado el modelo, puedes chatear de inmediato.
Ficha técnica
| Campo | Dato |
|---|---|
| Tipo | App cliente de LLM local (no es un modelo, es un frontend + motor de inferencia) |
| Plataformas | Android (Google Play) e iOS/iPadOS (App Store) |
| Desarrollador | Asghar Ghorbani · Gooya UG / marca LLM Ventures |
| País de origen | 🇩🇪 Alemania (Núremberg) |
| Licencia | MIT → código abierto real (licencia aprobada por la OSI) |
| Precio | Gratis, sin anuncios ni suscripción. Pals premium opcionales de pago |
| Versión actual | v1.19.0 (4 oct 2026) |
| Popularidad | +1 M descargas en Google Play · nota 3,4/5 · ~8.500 estrellas en GitHub |
| Motor de inferencia | llama.cpp (vía llama.rn), formato GGUF |
| Voz (TTS) | ONNX Runtime con voces Kokoro, Supertonic (31 idiomas) y otras |
| Idiomas de la interfaz | 11+ (incluye español) |
Matiz importante con sobre las licencias: la aplicación es de código abierto (MIT), pero los modelos que podamos utilizar tienen su propia licencia. Qwen o Phi suelen ser Apache 2.0/MIT (abiertos de verdad); Llama o Gemma son open weights con restricciones de uso.
Qué puede hacer
Desliza la tabla hacia los lados para verla entera →
| Función | Descripción | ¿100 % offline? |
|---|---|---|
| Chat local | Ejecuta modelos GGUF (Gemma, Qwen, Phi, Llama, etc.). Permite editar mensajes y regenerar respuestas | ✅ |
| Descarga desde Hugging Face | Buscador integrado de modelos GGUF; con token de HF accede también a modelos restringidos (gated) | ❌ (solo la descarga) |
| Ajuste de parámetros | Temperatura, longitud de contexto, system prompt, modo razonamiento (thinking) | ✅ |
| Pals | Asistentes personalizados con su propio modelo, prompt y personalidad (tipo Assistant o Roleplay) | ✅ |
| PalsHub | Tienda de Pals de la comunidad, algunos de pago (compra in-app solo en EE. UU.) | ❌ |
| Talents (herramientas) | El modelo puede usar calculadora, fecha/hora y renderizar HTML dentro del chat | ✅ |
| Búsqueda web | Herramientas web_search y read_url con tu propia clave de API (BYOK) | ❌ |
| Texto a voz | Lee las respuestas en voz alta con modelos neuronales locales | ✅ |
| Benchmark | Mide tokens/segundo y memoria; opcionalmente compara en el AI Phone Leaderboard | ✅ (compartir: ❌) |
| Servidores remotos | Conectar a un llama.cpp u otro servidor compatible en tu PC/red local para usar modelos grandes | ❌ (requiere red) |
| Exportar chats | Exporta una conversación a Markdown; chats fijados/destacados | ✅ |
Requisitos en Android
Desliza la tabla hacia los lados para verla entera →
| Nivel | RAM | Tipo de móvil | Modelos recomendados (cuantización Q4) | Experiencia esperada |
|---|---|---|---|---|
| Mínimo | 6 GB | Gama media reciente | 0,5B–1,5B (Qwen 2.5 0.5B/1.5B, Gemma 3 1B, Llama 3.2 1B) | Usable para respuestas cortas |
| Recomendado | 8 GB | Gama media-alta de los últimos 2–3 años | 2B–4B (Gemma 3 4B, Phi-4 Mini, Llama 3.2 3B, Qwen 3 4B) | Fluido; el «punto dulce» |
| Óptimo | 12–16 GB | Flagship con Snapdragon 8 Gen 2 o superior | 7B–8B (Qwen 3 8B, Llama 3.1 8B) | Funciona, pero más lento y con calentamiento |
Aceleración por hardware en Android: CPU (siempre), GPU Adreno vía OpenCL y NPU Qualcomm Hexagon; si no hay soporte, vuelve a la CPU automáticamente. Los móviles Snapdragon son los que más se benefician.
Almacenamiento: entre ~1–5 GB libres por modelo (un 3B en Q4 ronda los 2 GB).
Cómo empezar
- Instala PocketPal AI desde Google Play.
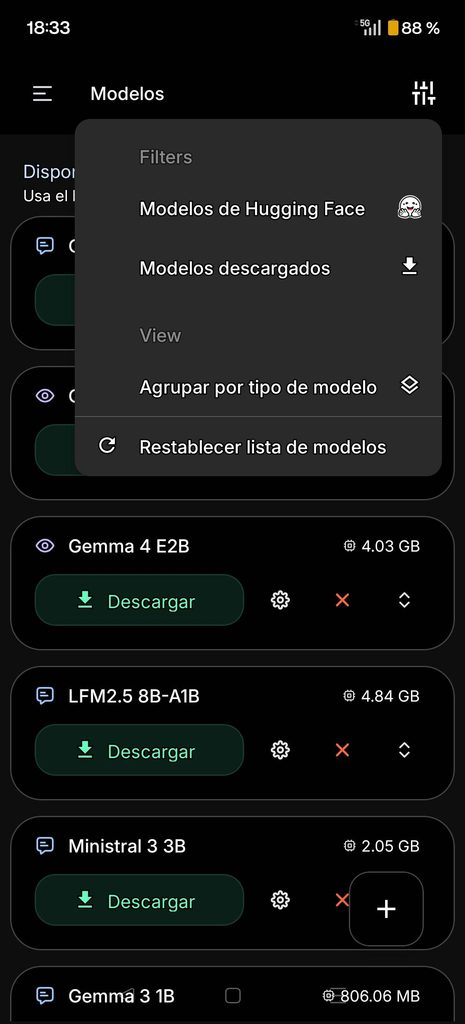
- Descarga un modelo: menú (☰) → Models → elige uno marcado como apto para tu móvil (la aplicación filtra por dispositivo) o pulsa + para buscar en Hugging Face.
- Carga el modelo (Load) y empieza a chatear.
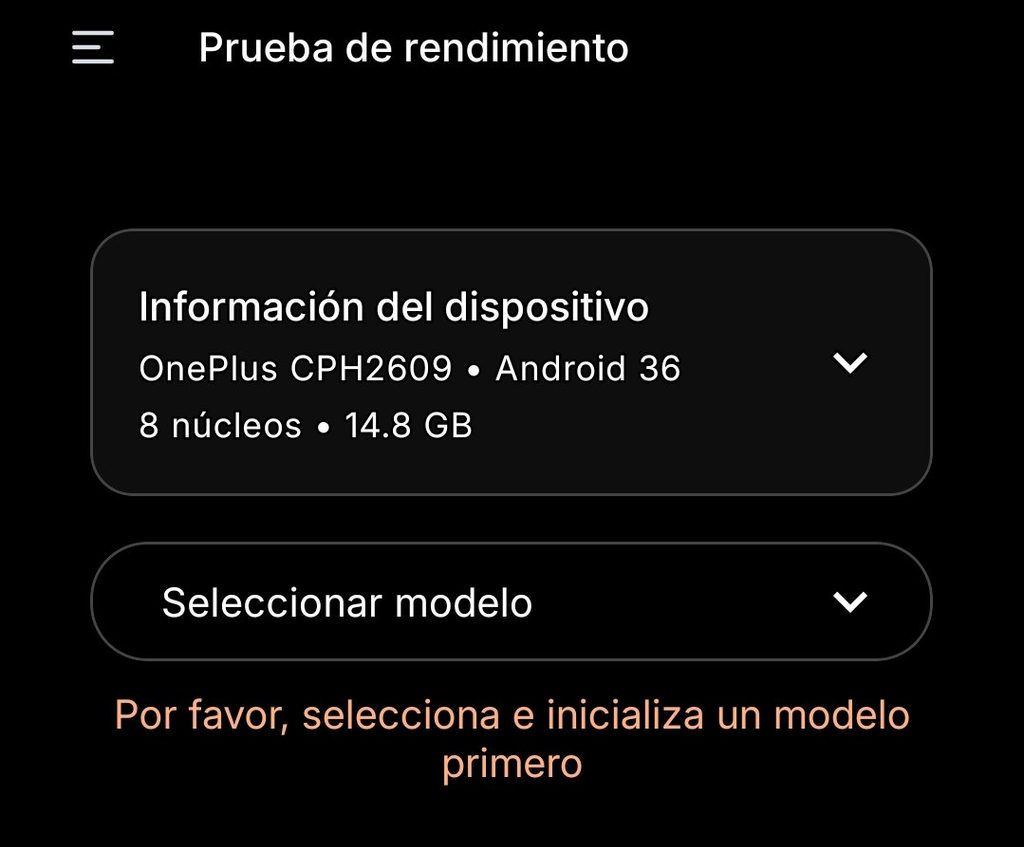
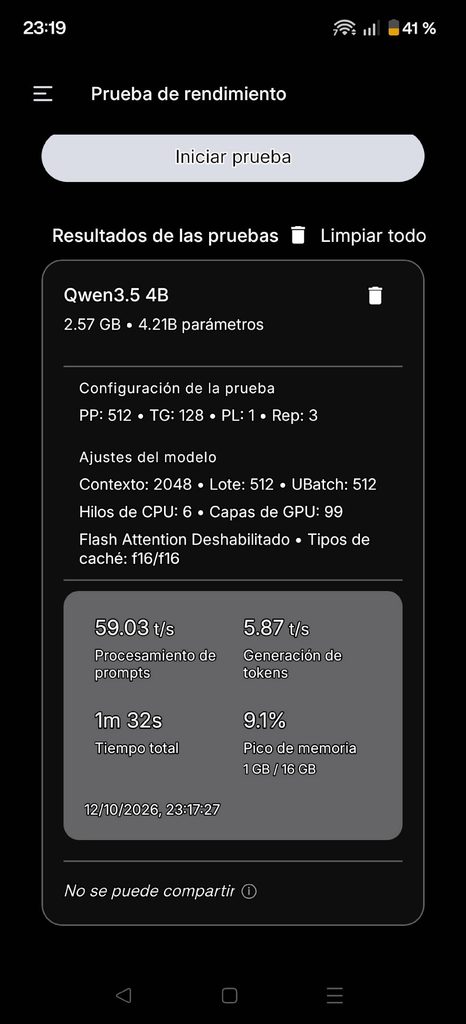
Sugerencia: antes de descargar un modelo grande, ejecuta el Benchmark con uno pequeño para ver cuántos tokens/segundo proporciona tu móvil. Por debajo de ~5 tokens/s la experiencia de uso es poco recomendable.
Privacidad
| Aspecto | Situación |
|---|---|
| Conversaciones | Se quedan en el dispositivo; no se suben a ningún servidor |
| Telemetría | El desarrollador afirma que no hay; al ser open source es verificable |
| Lo que sale del móvil | Solo lo que eliges compartir: resultados de benchmark, feedback, descargas de modelos y uso de PalsHub/búsqueda web |
| Ficha «Seguridad de los datos» de Play | Declara que puede recoger datos personales y financieros (presumiblemente por la cuenta y las compras de PalsHub). Conviene revisarla si no usas PalsHub |
Ventajas y limitaciones
| ✅ Ventajas | ❌ Limitaciones |
|---|---|
| Privacidad real: todo se procesa en local | Los modelos pequeños razonan y saben mucho menos que ChatGPT, Gemini o Claude |
| Funciona sin conexión | Consume batería y calienta el móvil en sesiones largas |
| Gratis, sin anuncios, código abierto (MIT) | Necesita 6–8 GB de RAM para una experiencia decente |
| Acceso a cientos de modelos de Hugging Face | Las voces TTS integradas reciben críticas de calidad en las reseñas |
| Desarrollo muy activo (versiones casi mensuales) | Valoración media modesta en Play (3,4/5), en parte por expectativas de usuarios con móviles poco potentes |
| Sin filtros de contenido impuestos por la app | Depende del modelo elegido: el usuario asume la responsabilidad |
Alternativas en Android
| App | Licencia | Diferencia principal |
|---|---|---|
| MLC Chat | Apache 2.0 (open source) | Motor MLC-LLM con aceleración GPU; catálogo de modelos más limitado |
| Gemini Nano (integrado) | Propietario | Viene en el sistema (Pixel, Galaxy); no eliges modelo |
| Ollama / LM Studio + cliente móvil | Varía | El modelo corre en tu PC y el móvil solo es la interfaz; permite modelos de 70B+ |
Experiencia de uso
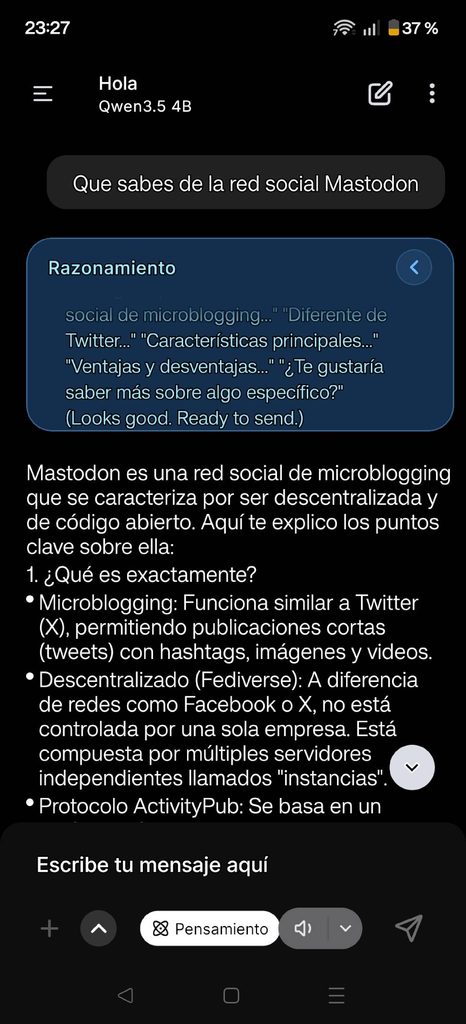
Como ya se ha comentado, la experiencia de uso será directamente proporcional a las prestaciones de nuestro teléfono y el modelo empleado. En el escenario de pruebas:
- CPU Snapdragon 8 Gen 2
- 16 Gb de Ram
- Modelo Qwen 3.5 4B (recomendado por la propia aplicación)
El resultado fue francamente decepcionante:
Tiempos empleados en cada función:
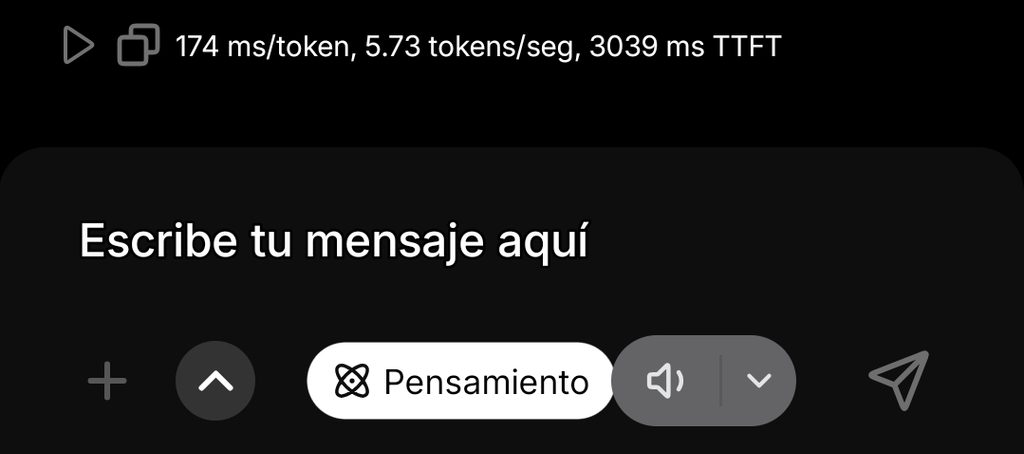
- 3039 ms TTFT (Time To First Token): lo que tardó en aparecer el primer token. Incluye sobre todo el procesamiento del prompt y del historial (inexistente al ser la primera consulta).
- 174 ms/token: el tiempo medio para generar cada token después del primero.
- 5,73 tokens/seg: la misma velocidad expresada a la inversa (1000 / 174 ≈ 5,73).
Para estimar el tiempo total, hay que sumar el TTFT y el tiempo de generación:Total ≈ TTFT + (nº de tokens generados × 174 ms). Por ejemplo, si la respuesta tuvo 300 tokens: 3,04 s + 300 × 0,174 s ≈ 3 + 52 ≈ 55 segundos.
Cálculo:
- La respuesta tiene unas 300 palabras.
- En español, con números, puntuación y formato, eso son aproximadamente 420–480 tokens.
- Generación: 450 tokens × 0,174 s ≈ 78 s.Más el TTFT: + 3 s.Total ≈ 81 s (horquilla de 76–87 s).
Si tenemos en cuenta que el proceso se efectúa en modo local y la sencillez de la pregunta; cualquier otro modo de consulta: buscador web, iA de buscador web o Chat de iA online (gratuito); es infinitamente más rápido y detallado.
A ésto cabría añadir el consumo de batería. Desde que se inició la prueba hasta la obtención de la respuesta final, casi un 5%.
Obviamente los resultados mejorarían con un modelo de menor peso (1,5–2B), a costa de unas respuestas menos elaboradas. Pero si tenemos en cuenta todo el proceso de forma global:
- Móvil de gama media/alta con 12 ó 16 Gb de Ram.
- Descarga y almacenamiento de varios Gb en el móvil.
- Pruebas y optimización de modelos y cuantización.
- Consumo de batería.
- Tiempos de respuesta.
- Opciones alternativas.
En mi opinión, no es un opción nada recomendable frente a cualquiera de las alternativas disponibles hoy en día.
Fuentes: Repositorio en GitHub · Notas de versión · Ficha en Google Play · Reseña en Gigazine (mar. 2026)